2021年1月29日金曜日

ジョインした表のロストアップデートの防止

1つのフォームで同時に2つの表を更新する際に、失われた更新の防止(ロストアップデート防止)がどのように働くか、確認してみました。Oracle APEXが標準で提供しているロストアップデートの防止については、以前に記事を書いています。


スキーマ定義


確認のために2つ簡単な表を作成しました。クイックSQLでの定義は以下です。行バージョン番号も生成しています。

# prefix: tst
# rowVersion: true
# semantics: default
concjoin1
    value1   vc80
    value11  vc80

concjoin2
    value2  vc80
    value22 vc80

生成されたDDLは以下です。行バージョン番号を付加するトリガーも生成されています。

create table tst_concjoin1 (
    id                             number generated by default on null as identity 
                                   constraint tst_concjoin1_id_pk primary key,
    row_version                    integer not null,
    value1                         varchar2(80),
    value11                        varchar2(80)
)
;

create table tst_concjoin2 (
    id                             number generated by default on null as identity 
                                   constraint tst_concjoin2_id_pk primary key,
    row_version                    integer not null,
    value2                         varchar2(80),
    value22                        varchar2(80)
)
;


-- triggers
create or replace trigger tst_concjoin1_biu
    before insert or update 
    on tst_concjoin1
    for each row
begin
    if inserting then
        :new.row_version := 1;
    elsif updating then
        :new.row_version := nvl(:old.row_version,0) + 1;
    end if;
end tst_concjoin1_biu;
/

create or replace trigger tst_concjoin2_biu
    before insert or update 
    on tst_concjoin2
    for each row
begin
    if inserting then
        :new.row_version := 1;
    elsif updating then
        :new.row_version := nvl(:old.row_version,0) + 1;
    end if;
end tst_concjoin2_biu;
/

対話グリッドのページ作成

以下のSQLをソースとする対話グリッドのページを作成します。

select
  t1.id,
  t1.value1,
  t2.value2
from tst_concjoin1 t1 join tst_concjoin2 t2
  on t1.id = t2.id

最初に空のアプリケーションを作成します。アプリケーション・ビルダーより、作成、新規アプリケーションの作成を実行し、アプリケーションの設定画面で名前だけ設定し、アプリケーションの作成をクリックします。

作成したアプリケーションより、ページ作成ウィザードを実行します。ページの作成をクリックします。

フォームを選択します。

編集可能対話グリッドを選択します。

ページ名を行の値 - VALUE1 & 2と設定し、次へ進みます。このページに作成する対話グリッドのプロパティ、失われた更新のタイプを行の値(これがデフォルトの設定です)として確認を行うため、この名前にします。

ナビゲーションのプリファレンスとして、新規ナビゲーション・メニュー・エントリの作成を選択し、次へ進みます。新規ナビゲーション・メニュー・エントリはデフォルトでページ名が設定されます。

データ・ソースとしてローカル・データベースを選択します。編集が有効をONにし、ソース・タイプはSQL問合せとし、SQL SELECT文を入力のところに、SQLを入力します。検証をクリックしてSQLを確認し、作成を実行します。


対話グリッドのリージョンを含んだページが作成されます。認識されている列を調整します。左ペインのレンダリング・ビューより、対話グリッドの列を開きます。


ROWIDを削除します。コンテキスト・メニューを開き、削除を実行します。


ID列を選択し、タイプを非表示、主キーをONに変更します。


ページを実行し、一行挿入してみます。


ORA-01776: 結合ビューを介して複数の実表を変更できません。というエラーが発生します。


対話グリッドのソースがSQLの場合、挿入/更新/削除の処理は、以下のようなSQLにて実施されます。

挿入は必ずエラーになります。挿入の対象が表TST_CONCJOIN1(IDとVALUE1)とTST_CONCJOIN2(VALUE2)の両方になるためです。

insert into
(
  select
    t1.id,
    t1.value1,
    t2.value2
  from tst_concjoin1 t1 join tst_concjoin2 t2
    on t1.id = t2.id
) t
values
(1,100,200);
ジョインをしていても、データを挿入する列が片方の表のみを対象としているときは、データの挿入が可能です。上記の例では、VALUE2を除けば表TST_CONCJOIN1のIDとVALUE1がデータの挿入の対象になります。ですので、VALUE2の問合せのみをONにして挿入の対象から除外すると、データの挿入時にエラーが発生せず、表TST_CONCJOIN1のみにデータが挿入されます。


今回の例では表TST_CONCJOIN1のみに行が挿入されても、同じIDが表TST_CONCJOIN2に存在しないため、ジョインした結果としては何も表示されません。

同様に、更新の場合は以下のようなSQLが実行されます。こちらも両方の表を同時に更新しようとするため、エラーになります。
update
(
  select
    t1.id,
    t1.value1,
    t2.value2
  from tst_concjoin1 t1 join tst_concjoin2 t2
    on t1.id = t2.id
) t
set t.value1 = 100, t.value2 = 200
where t.id = 1;

削除の場合は、表TST_CONCJOIN1のIDのみを対象とすることになるため、そちらの表の行のみ削除されます。

delete from
(
  select
    t1.id,
    t1.value1,
    t2.value2
  from tst_concjoin1 t1 join tst_concjoin2 t2
    on t1.id = t2.id
) t
where t.id = 1;
ジョインした表を対象に、それぞれを同時に更新するために以下のSQLを対話グリッドを処理するプロセスに設定します。
begin
  case :APEX$ROW_STATUS
  when 'C' then
    insert into tst_concjoin1(value1) values(:VALUE1) returning id into :ID;
    insert into tst_concjoin2(id, value2) values(:ID, :VALUE2);
  when 'U' then
    update tst_concjoin1 set value1 = :VALUE1 where id = :ID;
    update tst_concjoin2 set value2 = :VALUE2 where id = :ID;
  when 'D' then
    delete from tst_concjoin1 where id = :ID;
    delete from tst_concjoin2 where id = :ID;
  end case;
end;
左ペインにてプロセス・ビューを開いて、行の値 - VALUE1 & 2 - 対話グリッド・データの保存という名前のプロセスを選択します。タイプが対話グリッド - 行の自動処理(DML)であるプロセスです。設定のターゲット・タイプをPL/SQL Codeに変更し、挿入/更新/削除するPL/SQLコードに上記のSQLを設定します。

失われた更新はON、行のロックはYesとして、それぞれ有効にしておきます。


最後に対話グリッドのAttributesを開いて、失われた更新タイプが行の値となっていることを確認します。


以上で、最初のページは完成しました。あたかも、列としてValue1とValue2を持つ表を操作しているのと同じように、対話グリッドを操作できます。動かして確認してみましょう。


対話グリッドは必ずしも、単一の表だけが編集の対象ではなく、単一の表をイメージした操作を提供するコンポーネントになっています。


ロストアップデートの防止の動作確認


セッションを分離するため、異なるブラウザを立ち上げ、作成した対話グリッドのページをそれぞれ開きます。

Value1がJohn、Value2がKateである行が双方の対話グリッドに存在する状態です。


最初にKateをJaneに変更し、保存を実行します。


別のブラウザに操作を移動します。Value1がJohn、Value2がKateになっています。JohnをKenに変更し、保存をクリックします。


ユーザーが更新処理を開始してから、データベース内の現行バージョンのデータが変更されています。というエラーが発生します。


対話グリッドの失われた更新タイプとして行の値が設定されている場合、ソースから対話グリッドにデータを取得する際に、行の値からチェックサムも同時に生成します。以下のようなイメージです。
select 
    t1.id id,
    t1.value1 value1,
    t2.value2 value2, 
    apex_item.md5_checksum(t1.id, t1.value1, t2.value2) cs 
from tst_concjoin1 t1 join tst_concjoin2 t2
    on t1.id = t2.id
そして、更新処理を行う前に、変更対象の行に限定して、同じ問合せを発行しチェックサムを取得します。
select 
    t1.id id,
    t1.value1 value1,
    t2.value2 value2, 
    apex_item.md5_checksum(t1.id, t1.value1, t2.value2) cs 
from tst_concjoin1 t1 join tst_concjoin2 t2
    on t1.id = t2.id
where t1.id = 1 for update nowait
取得したチェックサムが一致すると、取り出した時点から保存されている行に変更が発生していないと判断して、実際の行の更新処理を行います。行のロックがYesになっていると、確認のためにチェックサムを取り出す際に、for updateを加えて行をロックします。チェックサムの再取得から実際の更新処理までは、ほとんど一瞬ですが、その間に行が変更されることを禁止しています。


ソースとして与えるSQLによっては、for updateが付けられるとエラーが発生したり、または意図したように表がロックされない場合があります。その場合は、Noとしてロックをかけるのを諦めるか(不要な場合もあります)、PL/SQL Codeにてロックをかけます。

アプリケーション開発時に意識をしていないと、高負荷のときに、実行されている処理の組み合わせに依存して、稀にアップデートした値が失われるという、原因の発見が難しい障害として顕在化する可能性があります。

単一表をソースとしている際には、ロストアップデートの防止はデフォルトで有効で、行のロックも有効であるため意識する必要はありません。

行の値が有効でないケースの確認


同じ手順で、ソースを以下のSQLに変更した対話グリッドのページを作成します。ページ名は行の値 - VALUE11 & 22とします。
select
  t1.id,
  t1.value11,
  t2.value22
from tst_concjoin1 t1 join tst_concjoin2 t2
  on t1.id = t2.id
操作の対象からVALUE1, VALUE2を除き、代わりにVALUE11, VALUE22と含めます。更新処理として記載するPL/SQL Codeは以下になります。
begin
  case :APEX$ROW_STATUS
  when 'C' then
    insert into tst_concjoin1(value11) values(:VALUE11) returning id into :ID;
    insert into tst_concjoin2(id, value22) values(:ID, :VALUE22);
  when 'U' then
    update tst_concjoin1 set value11 = :VALUE11 where id = :ID;
    update tst_concjoin2 set value22 = :VALUE22 where id = :ID;
  when 'D' then
    delete from tst_concjoin1 where id = :ID;
    delete from tst_concjoin2 where id = :ID;
  end case;
end;
先ほどと同様に、ブラウザを2つ開き、それぞれデータを更新します。


新しく追加した対話グリッドでデータを更新します。全行更新してもエラーは発生しません。


ソースでの取得対象に重なりがないため、他方が更新されてもチェックサムが変わるということがありません。

更新対象として重なりがなくても、ロストアップデートの防止を行いたい場合は、失われた更新タイプに行バージョン番号を選択します。

行バージョン番号による防止


ソースを以下のSQLに変更した対話グリッドのページを作成します。ページ名は行バージョン番号 - VALUE1 & 2とします。
select
  t1.id,
  t1.row_version + t2.row_version row_version,
  t1.value1,
  t2.value2
from tst_concjoin1 t1 join tst_concjoin2 t2
  on t1.id = t2.id
作成された対話グリッドのリージョンの列より、ROWIDを削除し、IDを非表示にします。さらに追加された 列ROW_VERSIONも非表示にします。ROW_VERSIONが対話グリッドより更新されることはありませんが、問合せのみはOFFにします。


更新に使用するPL/SQL Codeは、行の値 - VALUE1 & 2で設定したものと同じコードを使います。最後に対話グリッドのAttributesの失われた更新タイプを行バージョン列、行バージョン列をROW_VERSIONに変更します。


変更を保存すると、ページが完成です。続いて、ページ名を行バージョン番号 - VALUE11 & 22として、行の値 - VALUE11 & 22に対応するページを作成します。ソースは以下のSQLになります。
select
  t1.id,
  t1.row_version + t2.row_version row_version,
  t1.value11,
  t2.value22
from tst_concjoin1 t1 join tst_concjoin2 t2
  on t1.id = t2.id
更新に使用するPL/SQL Codeは、行の値 - VALUE11 & 22で設定したものと同じコードを使います。その他に指定する内容は、行バージョン番号 - VALUE1 & 2のページと同じです。

先ほどと同じ操作を行います。列Value2を全行更新します。


別のブラウザにて、列Value22を全行更新します。失われた更新タイプが行の値の際には発生しませんでしたが、今回はエラーになっています。


実は列ROW_VERSIONを問合せに含めた時点で(失われた更新タイプを行バージョン列として、列にROW_VERSIONを選ぶには、ソースのSQLにて取得が必須)チェックサムの計算にROW_VERSIONが含まれるため、設定が行の値のままでも結果は同じになります。ただし、列ROW_VERSIONがあるならチェックサムの計算は不要なので、ROW_VERSIONを選びましょう。

フォーム・リージョンの場合


Oracle APEXのバージョン19より、フォーム・リージョンが新設されています。フォーム・リージョンは、表の1行を対象として更新を行いますが、設定が対話グリッドど同じになるよう設計されています。

フォーム・リージョンについても、リージョンのソースとなるSQL問合せを設定します。


フォームに含まれるページ・アイテムの中で、主キーとなるページ・アイテムを決定します。


フォーム・リージョンのAttributesに、失われた更新タイプの設定が含まれます。


対話グリッドと同様に、更新処理を行うプロセスには、設定として、ターゲット・タイプ、挿入/更新/削除するPL/SQLコード(タイプがPL/SQL Codeの場合)、失われた更新の防止、行のロックがあります。


更新に使用するコード内では、列名ではなくページ・アイテム名をバインド変数名として使用します。ページ番号9にフォームがある場合、以下のようなコードになります。対話グリッドで使用したものと、基本的に違いはありません。
begin
  case :APEX$ROW_STATUS
  when 'C' then
    insert into tst_concjoin1(value11) values(:P9_VALUE11) returning id into :P9_ID;
    insert into tst_concjoin2(id, value22) values(:ID, :P9_VALUE22);
  when 'U' then
    update tst_concjoin1 set value11 = :P9_VALUE11 where id = :P9_ID;
    update tst_concjoin2 set value22 = :P9_VALUE22 where id = :P9_ID;
  when 'D' then
    delete from tst_concjoin1 where id = :P9_ID;
    delete from tst_concjoin2 where id = :P9_ID;
  end case;
end;

同一の行をフォームで開き、すでに別のブラウザから更新されている行に更新を行うと、対話グリッドの場合と同様にエラーが発生します。


本来であれば、対話グリッドとまったく同じ動作になるのですが、フォームの場合、現時点(2021年1月29日)では不具合のため、失われた更新タイプを行バージョン列に設定すると、新規行の挿入時にORA-01403: データが見つかりません。が発生します。そのため、行バージョン列を指定する前に、不具合が修正されているか確認する必要があります。


なお、対話グリッドと同様にソースのSQLにROW_VERSIONが含まれているため、失われた更新タイプが行の値であってもロストアップデートの防止はされます。この場合、本来必要のないチェックサムの計算が行われます。


動的アクションによる更新


動的アクションのサーバー側のコードを実行によって、表の値を更新することができます。便利な機能ですが、動的アクションによる更新には、今まで紹介してきたロストアップデートを防止する機能はありません。

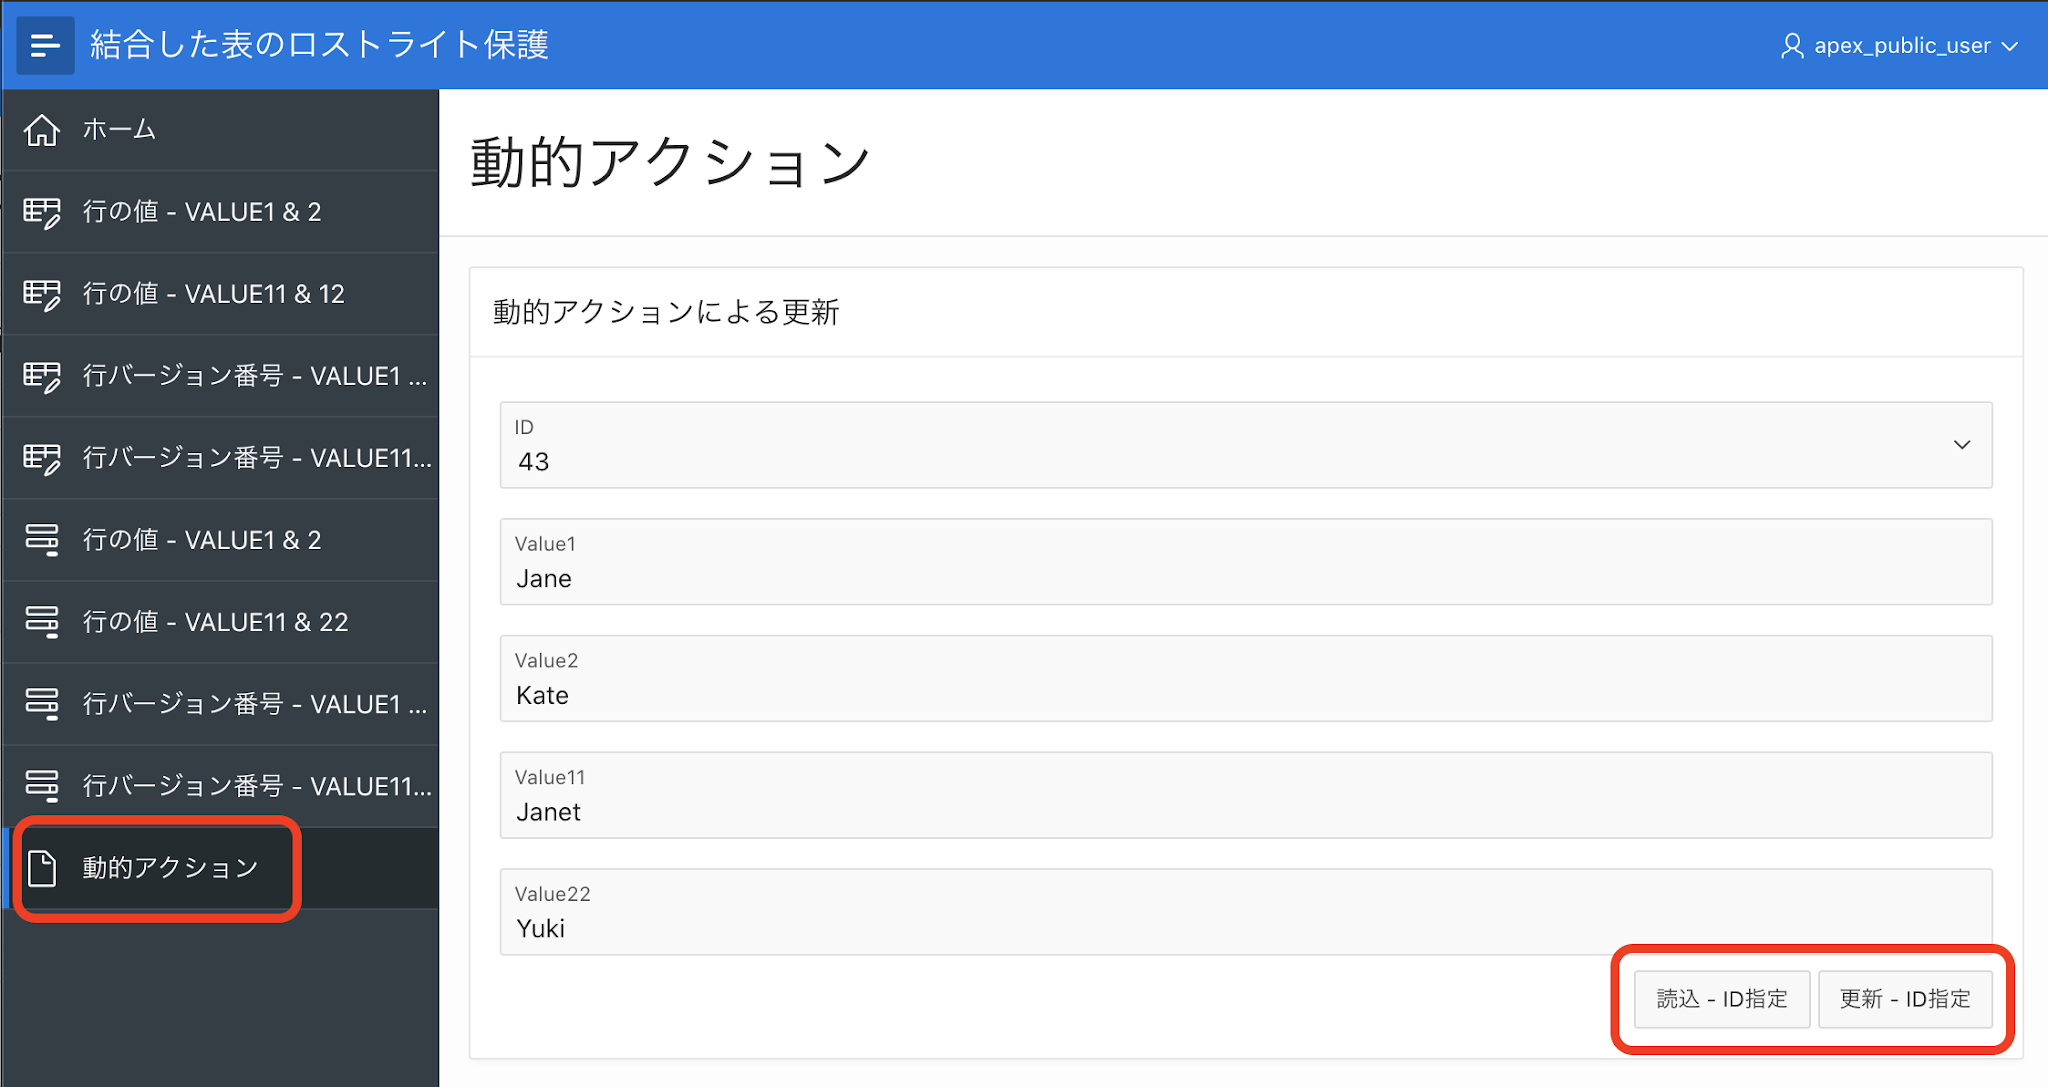
動的アクションによって、表TST_CONCJOIN1に列VALUE1、VALUE11、表TST_CONCJOIN2の列VALUE2、VALUE22の値の読込、更新を行うページを作ります。

ページ番号は14で作成しています。


ボタンのアクションは、動的アクションで定義します。

読込のボタンのPL/SQLコードは以下になります。
begin
    select
      t1.value1,
      t1.value11,
      t2.value2,
      t2.value22
    into
      :P14_VALUE1,
      :P14_VALUE11,
      :P14_VALUE2,
      :P14_VALUE22
    from tst_concjoin1 t1 join tst_concjoin2 t2
      on t1.id = t2.id
    where t1.id = :P14_ID;
end;
送信するアイテムとしてP14_ID、戻すアイテムはP14_VALUE1, P14_VALUE2, P14_VALUE11, P14_VALUE22の4つです。


更新のボタンのPL/SQLコードは以下になります。
begin
  update tst_concjoin1 set value1 = :P14_VALUE1, value11 = :P14_VALUE11 where id = :P14_ID;
  update tst_concjoin2 set value2 = :P14_VALUE2, value22 = :P14_VALUE22 where id = :P14_ID;
  commit;
end;
送信するアイテムとして、全てのページ・アイテムを指定します。


すでに存在するIDを見つけやすくするため、IDは選択リストとして、以下のSQLをLOVに登録しています。
select id d, id r from tst_concjoin1

ブラウザを2つ立ち上げ、同じIDを選択して読込を実行します。


何か値を変更し、更新を実行します。


別のブラウザへ移動し、値を変更して、更新します。エラーにならず更新できます。


最初のブラウザに戻り、読込を行うと、最後に更新したデータになり、そのブラウザにて更新したデータはなくなっています。


対話グリッドとフォームという標準のコンポーネントは、データを安全に更新するという機構が組み込まれていますが、動的アクションなどからSQLを呼び出して更新する場合などは、そういった機構が働かない、という点に注意を払ってアプリケーション開発を行う必要があります。

例えば、上記にROW_VERSIONを保持するページ・アイテムを追加し、ロストアップデートの防止を実装してみます。ページ番号は15とします。

データの読込時にROW_VERSIONも取得します。
begin
    select
      t1.value1,
      t1.value11,
      t2.value2,
      t2.value22,
      t1.row_version + t2.row_version
    into
      :P15_VALUE1,
      :P15_VALUE11,
      :P15_VALUE2,
      :P15_VALUE22,
      :P15_ROW_VERSION
    from tst_concjoin1 t1 join tst_concjoin2 t2
      on t1.id = t2.id
    where t1.id = :P15_ID;
end;

更新の際には、ROW_VERSIONの比較を行います。一致しないときはエラーにしています。

declare
  l_row_version number;
  expLostUpdate exception;
begin
  select t1.row_version + t2.row_version into l_row_version
  from tst_concjoin1 t1 join tst_concjoin2 t2 
      on t1.id = t2.id where t1.id = :P15_ID
  for update nowait;
  if l_row_version = :P15_ROW_VERSION then
      update tst_concjoin1 set value1 = :P15_VALUE1, value11 = :P15_VALUE11 where id = :P15_ID;
      update tst_concjoin2 set value2 = :P15_VALUE2, value22 = :P15_VALUE22 where id = :P15_ID;
  else
      raise expLostUpdate;
  end if;
  commit;
end;
標準コンポーネント以外による更新という意味では、REST APIについても同様にロストアップデートの防止の実装が必要な場合もあるかと思います。

今回作成したアプリケーションのエクスポートをこちらに置きました。
https://github.com/ujnak/apexapps/blob/master/exports/join-lostupdate.sql

ジョインした表のロストアップデートの防止についての説明は以上になります。Oracle APEXのアプリケーション開発の一助になれば幸いです。

完

2021年1月26日火曜日

Data Pump APIを使ったエクスポート/インポート

United CodesのDimitri Gielisさんが、Data Pump APIを使って新しいOracle APEX Application Developmentのサービスにダンプ・ファイルのインポートを行う記事を書いていました。

ワークスペースやAPEXのアプリケーションについては、手間ではありますが、アプリケーションごとにOracle APEXのアプリケーション・ビルダーよりエクスポート/インポートもできます。なので、Autonomous DatabaseからDataPump APIを使ってエクスポートを行って、そのダンプ・ファイルを別のAutonomous Databaseにインポートする手順を確認してみました。

ダンプ・ファイルの受け渡しにはオブジェクト・ストレージを使います。

オブジェクト・ストレージの準備については、以前にまとめた手順があるのですが、もう古い記事になってしまったので、スクリーション・ショットなども含めてやり直してみました。

コンパートメントの作成

すでに作成済みのコンパートメントを使う場合は、この手順は省略できます。また、この通りにコンパートメントを作成しなくても、ポリシーを定義するときに指定するコンパートメントを変更することで手順を進めることができます。

ルート・コンパートメントの直下にDUMPFILESという名前のコンパートメントを作成します。

OCIのコンソールにあるハンバーガー・アイコンをクリックしてメニューを表示させ、ガバナンスと管理に含まれるアイデンティティより、コンパートメントを呼び出します。


コンパートメント一覧の画面にあるコンパートメントの作成をクリックします。


開いたフォームに、作成するコンパートメントの名前をDUMPFILES、説明は任意ですが必須項目なので、適当な文章を入力します。親コンパートメントはルートを選びます。コンパートメントの作成を実行します。


ダイアログが閉じてもコンパートメントの一覧にDUMPFILESが現れない場合は、ブラウザのリロードを行ってください。表示されるまでに少し時間がかかるようです。


以上で、コンパートメントの準備が完了しました。

グループの作成


グループとしてDumpfileManagersを作成します。左のメニューからグループを選択し、グループの作成をクリックします。

名前をDumpfileManagersとし、説明は適当な文章を入力します。作成を実行します。


これでグループが作成されました。


ユーザーの作成


オブジェクト・ストレージを操作するためのユーザーdumpfile_managerを作成します。

アイデンティティの画面に戻って、左のメニューからユーザーを選択します。開いた画面にある、ユーザーの作成をクリックします。


IAMユーザーを選択し、名前にdumpfile_managerを指定します。説明は適当な文章を指定します。作成をクリックします。


ユーザーが作成されました。リソースよりグループを開き、作成されたユーザーをグループに追加します。


グループとしてDumpfileManagersを選択し、追加をクリックします。


ユーザーdumpfile_managerがグループDumpfileManagersに追加されました。


続けてユーザー機能の編集をクリックします。


認証トークンにチェックを入れ、変更の保存をクリックします。オブジェクト・ストレージのアクセスには、今作成したユーザー名と認証トークンをクリデンシャルとして使用することにします。


認証トークンを生成します。左のリソース・メニューより認証トークンを開きます。認証トークンのセクションにある、トークンの生成を実行します。


説明として適当な文章を入力し、トークンの生成を実行します。


生成されたトークンをクリップボードにコピーします。


クリップボードにコピーされたトークンは、どこかに大事に保持しておきます。オブジェクト・ストレージにアクセスするクリデンシャルを登録するDBMS_CLOUD.CREATE_CREDENTIALプロシージャの実行時に使用します。


以上でユーザーの作成は完了です。

ポリシーの作成


ルート・コンパートメントにポリシーDumpfileManagementPoliciesを作成します。

アイデンティティよりポリシーを選択します。コンパートメントにルートを選択し、開いた画面より、ポリシーの作成をクリックします。


名前をDumpfileManagementPoliciesとして指定します。説明として適当な文章を指定し、コンパートメントとしてルートを選択します。ポリシーの入力のために拡張ビルダーに切り替え、以下のポリシーを設定します。入力後、作成をクリックします。
Allow group DumpfileManagers to read buckets in compartment DUMPFILES
Allow group DumpfileManagers to manage objects in compartment DUMPFILES


ポリシーが登録されました。


バケットの作成


オブジェクト・ストレージにバケットを作成します。ハンバーガー・メニューよりオブジェクト・ストレージを選び、その中のオブジェクト・ストレージを開きます。


コンパートメントとして先に作成したDUMPFILESを選択し、バケットの作成をクリックします。


バケット名をTokyoと指定し、それ以外は変更せずに作成をクリックします。


バケットはこれで作成完了です。作成されたバケットTokyoのリンクをクリックし、バケットを開きます。


アップロードのテストもかねて小さなファイルをアップロードします。アップロードをクリックして、何かファイルをアップロードします。(アップロードの手順については省略します)。


アップロードしたオブジェクトの右端にある操作メニューを開き、オブジェクト詳細の表示を実行します。


URLパス(URI)より、バケットまでのパスを確認しておきます。


以上でオブジェクト・ストレージ側の準備も完了です。

スキーマのエクスポート


SQL Developer Webに管理者ユーザーADMINでサインインします。これからはSQLの実行画面で作業していきます。


最初に標準で作成されているディレクトリ・オブジェクトDATA_PUMP_DIR以下に、すでに存在するファイルを確認します。
SELECT * FROM DBMS_CLOUD.LIST_FILES('DATA_PUMP_DIR');

ファイルがあるかないかは、今まで実施してきた作業に依存します。ですので、結果がどうであれ、特に気にする必要はありません。エクスポートを実施する際に、同じファイル名を指定しないように気をつけてください。

Data Pump APIのマニュアルにある例を参照して、エクスポート処理を実行します。DBMS_DATAPUMP.OPENのjob_name、ADD_FILEのfilename、METADATA_FILTERのvalueといった引数は、それぞれの環境に合わせて必ず変更します。

DECLARE
  ind NUMBER;              -- Loop index
  h1 NUMBER;               -- Data Pump job handle
  percent_done NUMBER;     -- Percentage of job complete
  job_state VARCHAR2(30);  -- To keep track of job state
  le ku$_LogEntry;         -- For WIP and error messages
  js ku$_JobStatus;        -- The job status from get_status
  jd ku$_JobDesc;          -- The job description from get_status
  sts ku$_Status;          -- The status object returned by get_status
BEGIN

-- Create a (user-named) Data Pump job to do a schema export.

  h1 := DBMS_DATAPUMP.OPEN(
      operation => 'EXPORT',
      job_mode => 'SCHEMA',
      remote_link => NULL,
      job_name => 'EXP_APPDEV',
      version => 'LATEST'
  );

-- Specify a single dump file for the job (using the handle just returned)
-- and a directory object, which must already be defined and accessible
-- to the user running this procedure.

  DBMS_DATAPUMP.ADD_FILE(
      handle => h1,
      filename => 'apexdev1.dmp',
      directory => 'DATA_PUMP_DIR'
  );

-- A metadata filter is used to specify the schema that will be exported.

  DBMS_DATAPUMP.METADATA_FILTER(
      handle => h1,
      name => 'SCHEMA_EXPR',
      value => 'IN (''APEXDEV'')'
  );

-- Start the job. An exception will be generated if something is not set up
-- properly. 

  DBMS_DATAPUMP.START_JOB(
      handle => h1
  );

-- The export job should now be running. In the following loop, the job
-- is monitored until it completes. In the meantime, progress information is
-- displayed.
 
  percent_done := 0;
  job_state := 'UNDEFINED';
  while (job_state != 'COMPLETED') and (job_state != 'STOPPED') loop
    dbms_datapump.get_status(h1,
           dbms_datapump.ku$_status_job_error +
           dbms_datapump.ku$_status_job_status +
           dbms_datapump.ku$_status_wip,-1,job_state,sts);
    js := sts.job_status;

-- If the percentage done changed, display the new value.

    if js.percent_done != percent_done
    then
      dbms_output.put_line('*** Job percent done = ' ||
                           to_char(js.percent_done));
      percent_done := js.percent_done;
    end if;

-- If any work-in-progress (WIP) or error messages were received for the job,
-- display them.

   if (bitand(sts.mask,dbms_datapump.ku$_status_wip) != 0)
    then
      le := sts.wip;
    else
      if (bitand(sts.mask,dbms_datapump.ku$_status_job_error) != 0)
      then
        le := sts.error;
      else
        le := null;
      end if;
    end if;
    if le is not null
    then
      ind := le.FIRST;
      while ind is not null loop
        dbms_output.put_line(le(ind).LogText);
        ind := le.NEXT(ind);
      end loop;
    end if;
  end loop;

-- Indicate that the job finished and detach from it.

  dbms_output.put_line('Job has completed');
  dbms_output.put_line('Final job state = ' || job_state);
  dbms_datapump.detach(h1);
END;
/

スクリプト出力の一例です。

Starting "ADMIN"."EXP_APPDEV":  
Processing object type SCHEMA_EXPORT/TABLE/TABLE_DATA
Processing object type SCHEMA_EXPORT/TABLE/INDEX/STATISTICS/INDEX_STATISTICS
Processing object type SCHEMA_EXPORT/TABLE/STATISTICS/TABLE_STATISTICS
Processing object type SCHEMA_EXPORT/STATISTICS/MARKER
Processing object type SCHEMA_EXPORT/USER
Processing object type SCHEMA_EXPORT/SYSTEM_GRANT
Processing object type SCHEMA_EXPORT/DEFAULT_ROLE
Processing object type SCHEMA_EXPORT/TABLESPACE_QUOTA
Processing object type SCHEMA_EXPORT/PASSWORD_HISTORY
Processing object type SCHEMA_EXPORT/PRE_SCHEMA/PROCACT_SCHEMA
Processing object type SCHEMA_EXPORT/SEQUENCE/SEQUENCE
Processing object type SCHEMA_EXPORT/TABLE/TABLE
Processing object type SCHEMA_EXPORT/TABLE/IDENTITY_COLUMN
Processing object type SCHEMA_EXPORT/FUNCTION/FUNCTION
Processing object type SCHEMA_EXPORT/PROCEDURE/PROCEDURE
Processing object type SCHEMA_EXPORT/FUNCTION/ALTER_FUNCTION
Processing object type SCHEMA_EXPORT/PROCEDURE/ALTER_PROCEDURE
Processing object type SCHEMA_EXPORT/VIEW/VIEW
Processing object type SCHEMA_EXPORT/TABLE/INDEX/INDEX
Processing object type SCHEMA_EXPORT/TABLE/CONSTRAINT/CONSTRAINT
Processing object type SCHEMA_EXPORT/TABLE/CONSTRAINT/REF_CONSTRAINT
Processing object type SCHEMA_EXPORT/TABLE/TRIGGER
Processing object type SCHEMA_EXPORT/POST_SCHEMA/PROCACT_SCHEMA
*** Job percent done = 97
. . exported "APEXDEV"."CWR_MESSAGES"                    16.53 MB  153176 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_STOCKS"             116 KB     501 rows
. . exported "APEXDEV"."QS_TASKS"                        48.17 KB      73 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_SAMPLE_DATA"      25.43 KB     309 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_TASKS"            20.05 KB      73 rows
. . exported "APEXDEV"."TASKS"                           16.85 KB      73 rows
. . exported "APEXDEV"."PRD_TASKS"                       14.17 KB      73 rows
. . exported "APEXDEV"."PAC_TASKS"                       14.13 KB      73 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_POPULATION"       12.68 KB      51 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_STATS"            10.88 KB      22 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_ORDERS"           9.953 KB      20 rows
. . exported "APEXDEV"."EMP"                             10.06 KB      14 rows
. . exported "APEXDEV"."EMP2"                            9.828 KB      14 rows
. . exported "APEXDEV"."EMP_LOCAL"                       9.835 KB      14 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_BBALL"            9.210 KB      10 rows
. . exported "APEXDEV"."CWR_XLIFF_FILES"                 53.81 KB       3 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_GRADES"           8.820 KB      15 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_PROJECTS"         8.656 KB      14 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_EMP"              8.789 KB      14 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_PRODUCTS"         8.554 KB       5 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_SAMPLES"          8.398 KB     100 rows
. . exported "APEXDEV"."CWR_ORDERS"                      7.921 KB       4 rows
. . exported "APEXDEV"."WR_ORDERS"                       7.898 KB       4 rows
. . exported "APEXDEV"."EBA_DEMO_CHART_SAMPLE_NAMES"     7.765 KB       5 rows
. . exported "APEXDEV"."CWR_MENUS_TL"                    6.640 KB      12 rows
. . exported "APEXDEV"."WR_MENUS_TL"                     6.632 KB      12 rows
. . exported "APEXDEV"."TST_EMPLOYEES"                   6.578 KB      30 rows
. . exported "APEXDEV"."CWR_MENUS"                       6.414 KB       3 rows
. . exported "APEXDEV"."WR_MENUS"                        6.414 KB       3 rows
. . exported "APEXDEV"."REMEMP"                          6.460 KB       3 rows
. . exported "APEXDEV"."PAC_EMPLOYEES"                   6.281 KB      12 rows
. . exported "APEXDEV"."PRD_EMPLOYEES"                   6.281 KB      12 rows
. . exported "APEXDEV"."PAC_PROJECTS"                    6.101 KB      15 rows
. . exported "APEXDEV"."PRD_PROJECTS"                    6.101 KB      15 rows
. . exported "APEXDEV"."DEPT"                            6.031 KB       4 rows
*** Job percent done = 99
. . exported "APEXDEV"."EBA_DEMO_CHART_DEPT"             6.046 KB       4 rows
ORA-39173: Encrypted data has been stored unencrypted in dump file set.
Master table "ADMIN"."EXP_APPDEV" successfully loaded/unloaded
*** Job percent done = 100
******************************************************************************
Dump file set for ADMIN.EXP_APPDEV is:
  /u03/dbfs/AEC9AD8F7E8D9C5AE0532010000A7CA7/data/dpdump/apexdev1.dmp
Job "ADMIN"."EXP_APPDEV" successfully completed at Tue Jan 26 09:27:07 2021
elapsed 0 00:01:08
Job has completed
Final job state = COMPLETED


PL/SQL procedure successfully completed.

Elapsed: 00:01:18.397

スクリプト出力より、エクスポート・ダンプが以下に出力されていることが確認できます。これも今までの作業が違うため、それぞれ異なった値になります。

/u03/dbfs/AEC9AD8F7E8D9C5AE0532010000A7CA7/data/dpdump/apexdev1.dmp


ダンプ・ファイルのオブジェクト・ストレージのへの配置


スクリプト出力からも確認しましたが、再度、DATA_PUMP_DIR以下に作成されているダンプ・ファイルのファイル名を確認します。
SELECT * FROM DBMS_CLOUD.LIST_FILES('DATA_PUMP_DIR');
リストされたファイルをオブジェクト・ストレージに配置します。最初にオブジェクト・ストレージにアクセスするためのクリデンシャルを登録します。

DBMS_CLOUD.CREATE_CREDENTIALプロシージャを呼び出し、ユーザーdumpfile_managerと、その認証トークンをクリデンシャル名EXPIMP_CREDとして登録します。
BEGIN
  DBMS_CLOUD.CREATE_CREDENTIAL(
    credential_name => 'EXPIMP_CRED',
    username => 'dumpfile_manager',
    password => 'dumpfile_managerの認証トークン'
  );
END;
/

続いて、DBMS_CLOUD.PUT_OBJECTプロシージャを呼び出し、DATA_PUMP_DIR以下に存在するダンプ・ファイルを作成済みのオブジェクト・ストレージのバケットにコピーします。object_uriはバケットを作成したときに確認したURIから、file_nameはDATA_PUMP_DIRにファイル一覧から決めます。ダンプ・ファイルが複数の場合は、複数回実行します。

BEGIN
   DBMS_CLOUD.PUT_OBJECT(credential_name => 'EXPIMP_CRED',
     object_uri => 'https://objectstorage.ap-tokyo-1.oraclecloud.com/n/nr8354yuxaxx/b/Tokyo/o/apexdev1.dmp',
     directory_name => 'DATA_PUMP_DIR',
     file_name => 'apexdev1.dmp');
END;

プロシージャの実行が正常に終了したら、オブジェクト・ストレージの画面よりファイルが存在しているか確認してください。

ダンプ・ファイルがオブジェクト・ストレージに存在していれば、エクスポートの作業は完了です。


オブジェクト・ストレージからのダンプ・ファイルの取得


インポートを行うインスタンスのSQL Developer Webに管理者ユーザーADMINでサインインします。

最初にディレクトリDATA_PUMP_DIRの内容を確認します。

SELECT * FROM DBMS_CLOUD.LIST_FILES('DATA_PUMP_DIR');

次にエクスポートを実施したインスタンスで実行したのと同様に、DBMS_CLOUD.CREATE_CREDENTIALプロシージャを呼び出し、オブジェクト・ストレージのアクセスに使用するクリデンシャルを登録します。

BEGIN
  DBMS_CLOUD.CREATE_CREDENTIAL(
    credential_name => 'EXPIMP_CRED',
    username => 'dumpfile_manager',
    password => 'dumpfile_managerの認証トークン'
  );
END;
/

続いて、DBMS_CLOUD.GET_OBJECTプロシージャを呼び出し、オブジェクト・ストレージ上のダンプ・ファイルをDATA_PUMP_DIR以下に配置します。

begin
   DBMS_CLOUD.GET_OBJECT(
     credential_name => 'EXPIMP_CRED',
     object_uri => 'https://objectstorage.ap-tokyo-1.oraclecloud.com/n/nr8354yuxaxx/b/Tokyo/o/apexdev1.dmp',
     directory_name => 'DATA_PUMP_DIR'); 
end;

プロシージャが成功したら、ディレクトリDATA_PUMP_DIR以下のファイル一覧を確認します。

SELECT * FROM DBMS_CLOUD.LIST_FILES('DATA_PUMP_DIR');

ダンプ・ファイルが配置されていることを確認し、Data Pump APIを使ったインポート処理を実行します。実行するスクリプトはData Pump APIのマニュアルに記載されている例を元にしています。

DBMS_DATAPUMP.OPENのjob_name、DBMS_DATAPUMP.ADD_FILEのfilename、DBMS_DATAPUMP.METADATA_REMAPなどは環境に応じて必ず変更が発生するはずです。

DECLARE
  ind NUMBER;              -- Loop index
  h1 NUMBER;               -- Data Pump job handle
  percent_done NUMBER;     -- Percentage of job complete
  job_state VARCHAR2(30);  -- To keep track of job state
  le ku$_LogEntry;         -- For WIP and error messages
  js ku$_JobStatus;        -- The job status from get_status
  jd ku$_JobDesc;          -- The job description from get_status
  sts ku$_Status;          -- The status object returned by get_status
BEGIN

-- Create a (user-named) Data Pump job to do a "full" import (everything
-- in the dump file without filtering).

  h1 := DBMS_DATAPUMP.OPEN(
      operation => 'IMPORT',
      job_mode => 'FULL',
      remote_link => NULL,
      job_name => 'IMP_APEXDEV'
  );

-- Specify the single dump file for the job (using the handle just returned)
-- and directory object, which must already be defined and accessible
-- to the user running this procedure. This is the dump file created by
-- the export operation in the first example.

  DBMS_DATAPUMP.ADD_FILE(
      handle => h1,
      filename => 'apexdev1.dmp',
      directory => 'DATA_PUMP_DIR'
  );

-- A metadata remap will map all schema objects from HR to BLAKE.

  DBMS_DATAPUMP.METADATA_REMAP(
      handle => h1,
      name => 'REMAP_SCHEMA',
      old_value => 'APEXDEV',
      value => 'APEXDEV2'
  );

-- If a table already exists in the destination schema, skip it (leave
-- the preexisting table alone). This is the default, but it does not hurt
-- to specify it explicitly.

  DBMS_DATAPUMP.SET_PARAMETER(
      handle => h1,
      name => 'TABLE_EXISTS_ACTION',
      value => 'SKIP'
  );

-- Start the job. An exception is returned if something is not set up properly.

  DBMS_DATAPUMP.START_JOB(h1);

-- The import job should now be running. In the following loop, the job is 
-- monitored until it completes. In the meantime, progress information is 
-- displayed. Note: this is identical to the export example.
 
 percent_done := 0;
  job_state := 'UNDEFINED';
  while (job_state != 'COMPLETED') and (job_state != 'STOPPED') loop
    dbms_datapump.get_status(h1,
           dbms_datapump.ku$_status_job_error +
           dbms_datapump.ku$_status_job_status +
           dbms_datapump.ku$_status_wip,-1,job_state,sts);
    js := sts.job_status;

-- If the percentage done changed, display the new value.

     if js.percent_done != percent_done
    then
      dbms_output.put_line('*** Job percent done = ' ||
                           to_char(js.percent_done));
      percent_done := js.percent_done;
    end if;

-- If any work-in-progress (WIP) or Error messages were received for the job,
-- display them.

       if (bitand(sts.mask,dbms_datapump.ku$_status_wip) != 0)
    then
      le := sts.wip;
    else
      if (bitand(sts.mask,dbms_datapump.ku$_status_job_error) != 0)
      then
        le := sts.error;
      else
        le := null;
      end if;
    end if;
    if le is not null
    then
      ind := le.FIRST;
      while ind is not null loop
        dbms_output.put_line(le(ind).LogText);
        ind := le.NEXT(ind);
      end loop;
    end if;
  end loop;

-- Indicate that the job finished and gracefully detach from it. 

  dbms_output.put_line('Job has completed');
  dbms_output.put_line('Final job state = ' || job_state);
  dbms_datapump.detach(h1);
END;
/

スクリプト出力に表示された実行結果の一例です。

Master table "ADMIN"."IMP_APEXDEV" successfully loaded/unloaded
Starting "ADMIN"."IMP_APEXDEV":  
Processing object type SCHEMA_EXPORT/USER
Processing object type SCHEMA_EXPORT/SYSTEM_GRANT
Processing object type SCHEMA_EXPORT/DEFAULT_ROLE
Processing object type SCHEMA_EXPORT/TABLESPACE_QUOTA
Processing object type SCHEMA_EXPORT/PASSWORD_HISTORY
Processing object type SCHEMA_EXPORT/PRE_SCHEMA/PROCACT_SCHEMA
Processing object type SCHEMA_EXPORT/SEQUENCE/SEQUENCE
Processing object type SCHEMA_EXPORT/TABLE/TABLE
Processing object type SCHEMA_EXPORT/TABLE/TABLE_DATA
. . imported "APEXDEV2"."CWR_MENUS"                      6.414 KB       3 rows
. . imported "APEXDEV2"."EMP_LOCAL"                      9.835 KB      14 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_BBALL"           9.210 KB      10 rows
*** Job percent done = 99
. . imported "APEXDEV2"."CWR_MESSAGES"                   16.53 MB  153176 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_TASKS"           20.05 KB      73 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_POPULATION"      12.68 KB      51 rows
. . imported "APEXDEV2"."PRD_EMPLOYEES"                  6.281 KB      12 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_PROJECTS"        8.656 KB      14 rows
. . imported "APEXDEV2"."CWR_ORDERS"                     7.921 KB       4 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_SAMPLE_DATA"     25.43 KB     309 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_STATS"           10.88 KB      22 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_STOCKS"            116 KB     501 rows
. . imported "APEXDEV2"."WR_MENUS_TL"                    6.632 KB      12 rows
. . imported "APEXDEV2"."CWR_XLIFF_FILES"                53.81 KB       3 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_SAMPLES"         8.398 KB     100 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_EMP"             8.789 KB      14 rows
. . imported "APEXDEV2"."PAC_PROJECTS"                   6.101 KB      15 rows
. . imported "APEXDEV2"."PRD_PROJECTS"                   6.101 KB      15 rows
. . imported "APEXDEV2"."QS_TASKS"                       48.17 KB      73 rows
. . imported "APEXDEV2"."WR_MENUS"                       6.414 KB       3 rows
. . imported "APEXDEV2"."DEPT"                           6.031 KB       4 rows
. . imported "APEXDEV2"."EMP"                            10.06 KB      14 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_PRODUCTS"        8.554 KB       5 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_DEPT"            6.046 KB       4 rows
. . imported "APEXDEV2"."PAC_TASKS"                      14.13 KB      73 rows
. . imported "APEXDEV2"."PRD_TASKS"                      14.17 KB      73 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_ORDERS"          9.953 KB      20 rows
. . imported "APEXDEV2"."TST_EMPLOYEES"                  6.578 KB      30 rows
. . imported "APEXDEV2"."REMEMP"                         6.460 KB       3 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_GRADES"          8.820 KB      15 rows
. . imported "APEXDEV2"."WR_ORDERS"                      7.898 KB       4 rows
. . imported "APEXDEV2"."TASKS"                          16.85 KB      73 rows
. . imported "APEXDEV2"."PAC_EMPLOYEES"                  6.281 KB      12 rows
. . imported "APEXDEV2"."CWR_MENUS_TL"                   6.640 KB      12 rows
. . imported "APEXDEV2"."EMP2"                           9.828 KB      14 rows
. . imported "APEXDEV2"."EBA_DEMO_CHART_SAMPLE_NAMES"    7.765 KB       5 rows
Processing object type SCHEMA_EXPORT/TABLE/IDENTITY_COLUMN
Processing object type SCHEMA_EXPORT/FUNCTION/FUNCTION
Processing object type SCHEMA_EXPORT/PROCEDURE/PROCEDURE
Processing object type SCHEMA_EXPORT/FUNCTION/ALTER_FUNCTION
Processing object type SCHEMA_EXPORT/PROCEDURE/ALTER_PROCEDURE
Processing object type SCHEMA_EXPORT/VIEW/VIEW
Processing object type SCHEMA_EXPORT/TABLE/INDEX/INDEX
Processing object type SCHEMA_EXPORT/TABLE/CONSTRAINT/CONSTRAINT
Processing object type SCHEMA_EXPORT/TABLE/INDEX/STATISTICS/INDEX_STATISTICS
Processing object type SCHEMA_EXPORT/TABLE/CONSTRAINT/REF_CONSTRAINT
Processing object type SCHEMA_EXPORT/TABLE/TRIGGER
Processing object type SCHEMA_EXPORT/TABLE/STATISTICS/TABLE_STATISTICS
Processing object type SCHEMA_EXPORT/STATISTICS/MARKER
Processing object type SCHEMA_EXPORT/POST_SCHEMA/PROCACT_SCHEMA
Job "ADMIN"."IMP_APEXDEV" successfully completed at Tue Jan 26 10:18:26 2021
elapsed 0 00:00:47
Job has completed
Final job state = COMPLETED


PL/SQL procedure successfully completed.

Elapsed: 00:00:57.454

インポートされた表などは、SQL Developer Webを使用して確認することができます。

以上で、Data Pump APIを使ったエクスポートとインポート作業の紹介は完了です。Oracle APEXを使ったアプリケーション開発の一助になれば幸いです。

追記

DATA_PUMP_DIR以下のファイルを削除するには、DBMS_CLOUD.DELETE_FILEプロシージャを使用します。

begin
    dbms_cloud.delete_file(
        directory_name => 'DATA_PUMP_DIR',
        file_name => 'apexdev1.dmp');
end;

完

2021年1月25日月曜日

クイックSQLのすすめ

最近は新たに表を作る時は、もっぱらクイックSQLを使っています。こういう使い方をした方が便利だな、と感じたことをまとめてみます。

いきなり仕様を読むのもつらいので、その前段階の使い方の紹介になります。仕様そのものについては、オンライン・ヘルプを参照してください。

クイックSQLが使えるサイト

Oracle APEXがインストールされていれば、どこでも。SQLワークショップに含まれるユーティリティを開いて、クイックSQLを実行します。

LiveSQL - https://livesql.oracle.com - でも、クイックSQLを実行できます。


コメントによるインライン設定


クイックSQLによる記述を元に生成されるDDLは、設定によって変わります。


ただし、この画面上の設定は保存されず、新たにクイックSQLを開く度に、毎回設定し直す必要があります。その手間を省くために、コメントによってインライン設定を行うことができます。詳しい記述方法については、オンライン・ヘルプの設定を参照してください。


一度設定を決めると変更することはあまり無いため、インライン設定はとても便利です。

モデルの保存


クイックSQLで記載したモデルを保存することができます。モデルの保存をクリックします。


モデル名と説明を入力し、モデルの保存を実行します。


保存したモデルはロードから、マイ・モデルを選んで、モデルのロードを実行することでリストアできます。


保存されたモデルを更新する方法は、見つけることができませんでした(LiveSQLのQuick SQLにはUpdate Modelの機能があります)。別の名前で保存するか、保存済みのモデルを事前に削除する必要があります。

コメントによるインライン設定もモデルとして保存されます。そのため、インライン設定をしていれば、モデルをロードする度に画面上で設定を繰り返す必要がありません。

表定義の基本


表の名前を記述し、次の行からインデントを付けて、その表の列を記述していきます。
# date: timestamp with local time zone
customers
    name vc80
    register_date
    age num
列名に続けて、列の型を指定します。

num (number)、vcNN (varchar2(NN))、date(型は設定による)が主に使われる型指定になるでしょう。列名の末尾にdateが付いていると型指定なしでも、date型と認識されます。

date型は、date設定によって生成されるDDLの型指定が変わります。以下のように、date設定をtimestamp with local time zoneとすると、date型として指定した列はすべてtimestamp with local time zone型としてDDLが生成されます。
# date: timestamp with local time zone
スキーマ定義でdate型とtimestamp with local time zone型を混在させることはあまりない、と思います。その場合はクイックSQLではdateとして記述し、設定で実際の型を決める方が良いでしょう。timestamp with time zone型とtimestamp with local time zone型が混在する場合など、型を特定する必要がある場合は、明示的に型を指定します。その場合でも、tstz, tsltzといった短縮した文字列で型を指定できます。

データ型の詳細は、オンライン・ヘルプのデータ型を参照してください。オンライン・ヘルプには、tstzでもtimestamp with local time zoneになると記載されていますが、実際はきちんとtimestamp with time zone型としてDDLが生成されます。


列の制約の指定


一番使うのはNOT NULL制約だと思います。列の型指定に続けて /nn (/not null)と記載します。そのほかでは外部キー制約を指定する /fk (/references, /reference)や、列のデフォルト値を指定する /default があります。

列の制約については、オンライン・ヘルプの列ディレクティブに説明があります。


クイックSQLを使うまではあまりチェック制約 /check を表に定義したことはなかったのですが、クイックSQLを使うようになってから、 以下のように列を定義することが増えました。
    is_enabled vc1 /check Y,N /default N /nn
以下のDDLが生成されます。
    is_enabled                     varchar2(1) default 'N' constraint customers_is_enabled_cc
                                   check (is_enabled in ('Y','N')) not null,
クイックSQLの癖のようなものかもしれませんが、/defaultは/checkの後に指定した方が良いです。順番によってはDDLが適切に生成されません。
    is_enabled vc1 /nn /default N /check Y,N
生成されたDDLです。is_enabled_vc1__/default_nがチェック制約を適用する列名になってしまっています。
    is_enabled                     varchar2(1) default 'N' constraint customers_is_enabled_vc_cc
                                   check (is_enabled_vc1__/default_n in ('Y','N')) not null,

マスター・ディテイル関係の表の定義


最初にマスター表を定義します。ディテイル表はインデントを付けて定義します。
# semantics: default
orders
    customer_name
    order_date
    order_items
        product_name
        price num
        quantity num
ordersがマスター表で、order_itemsがディテイル表です。order_itemsは続いて列が定義されているので、表と認識されます。以下のDDLが生成され、order_items表にはマスター表の列を保持するorder_id列が追加され、外部キー制約としてマスター表の主キーを参照しています。
-- create tables
create table orders (
    id                             number generated by default on null as identity 
                                   constraint orders_id_pk primary key,
    customer_name                  varchar2(255),
    order_date                     date
)
;

create table order_items (
    id                             number generated by default on null as identity 
                                   constraint order_items_id_pk primary key,
    order_id                       number
                                   constraint order_items_order_id_fk
                                   references orders on delete cascade,
    product_name                   varchar2(255),
    price                          number,
    quantity                       number
)
;

-- table index
create index order_items_i1 on order_items (order_id);
削除時の動作は、ondelete設定としてcascade、restrict、set nullの中から選ぶことが可能です。

主キー定義


自動主キーという設定があり、これをONにすると、主キーとなる列が自動的に追加されます。クイックSQLでは、自動主キーをONにすることが推奨されています。自動主キーがOFFのときは、主キー列は自動生成されません。そのため、主キーとなる列を定義に含め /pk を制約として付加します。
customers
    customer_id num /pk
    name vc80
    register_date
    age num
主キー制約 /pk が明示された列が存在する場合は、自動主キーがONでも主キー列は自動生成されません。

生成される主キーに関するDDLは、いくつかの設定から影響を受けます。 prefixPKwithTname、 PK、DBの3つの設定です。
# prefixPKwithTname: true
# PK: identity
# DB: 18c
customers
    name vc80
    register_date
    age num
prefixPKwithTnameがtrueの場合、主キー列は表名_idになります。falseの場合は単にidです。PKはguid, seq, identityの3種類のうちのどれかを設定します。

PKとしてguidを設定したときに生成される、主キーの定義は以下になります。
    customer_id                    number default on null to_number(sys_guid(), 'XXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXX') 
                                   constraint customers_id_pk primary key,
seqの場合は以下です。これ以外に順序customer_seqを作成するDDLも生成されます。
    customer_id                    number default on null customers_seq.NEXTVAL 
                                   constraint customers_id_pk primary key,
identityの場合は以下です。
    customer_id                    number generated by default on null as identity 
                                   constraint customers_id_pk primary key,
identityはOracle Database 12c以降で利用可能な指定なので、DBが11gの場合は、guidを指定した場合と同じDDLが生成され、identityの設定は無視されます。

生成されるDDLは、Oracle APEXのバージョンによっても異なります。できるだけ新しいバージョンのOracle APEXに含まれるクイックSQLを使用することにより、より適切なDDLを生成することができます。

外部キー制約


マスター表に含める形でディテイル表を定義すると、自動的に外部キー制約がDDLに追加されます。そうではなく、外部キー制約を明示する場合は、/fk (または/references, /reference) を指定します。

先に利用した例ordersとorder_items表をインデントを使わずに定義すると、以下の記述になります。
 # semantics: default
orders
    customer_name
    order_date

order_items
    order_id /fk orders
    product_name
    price num
    quantity num

外部キーの宛先となる表は、すでに作成済みであるか、外部キー制約を持つ表より先に定義されている(つまり、先にDDLが実行され表として作成される)必要があります。

監査列について


設定の追加列に監査列という設定があります。インライン設定では、auditColsです。


この設定をONにすると、作成された列名、作成者の列名、更新された列名、更新者の列名の4つの列を含んだDDLが生成され、また、それらの列に値を設定するデータベース・トリガーも生成されます。


表については、以下のように列が追加されます。
    created                        date not null,
    created_by                     varchar2(255) not null,
    updated                        date not null,
    updated_by                     varchar2(255) not null
生成されるトリガーのDDLは、設定のAPEX有効がONかOFFかで異なります。

APEX有効がONの場合は、次のDDLが生成されます。APEXが使用されていることを前提として、APEX$SESSIONよりユーザー名APEX_USERを取得し、列に保存します。作成時刻、更新時刻のデータ型はdate設定から決まります。
-- triggers
create or replace trigger orders_biu
    before insert or update 
    on orders
    for each row
begin
    if inserting then
        :new.created := sysdate;
        :new.created_by := coalesce(sys_context('APEX$SESSION','APP_USER'),user);
    end if;
    :new.updated := sysdate;
    :new.updated_by := coalesce(sys_context('APEX$SESSION','APP_USER'),user);
end orders_biu;
/
OFFの場合はデータベースの接続ユーザーを取得し、列に保存します。
-- triggers
create or replace trigger orders_biu
    before insert or update 
    on orders
    for each row
begin
    if inserting then
        :new.created := sysdate;
        :new.created_by := user;
    end if;
    :new.updated := sysdate;
    :new.updated_by := user;
end orders_biu;
/
監査列はあくまでシステム上の要件で使用し、これをビジネス・ロジックの中で使用することは推奨しません。例えば注文情報を登録した顧客を表ORDERSに保存する場合は、列CUSTOMERといった列を定義し、監査列のCREATED_BYを流用してはいけません。特にトリガーによって更新される場合、データのメンテナンスのために発行したSQLによっても監査列は更新されます。監査用途であれば、その変更が記録されるのは適切です。しかし、注文情報を登録したユーザー、つまりビジネス上の意味を持たせていると問題が発生します。

監査列をビジネス・ロジックの中で取り扱わないことにすると、Oracle APEXのアプリケーションのレポートやフォームでは、それらの列は無いものとして扱うことになります。

しかし実際に列から削除すると、表定義が変更されたときにページ・アイテムの同期化を実行する度に、再度、監査列が追加されることになります。タイプを非表示に変更する、もしくは、ビルド・オプションに紐づけて非表示にする、という対応を行う方が良いでしょう。


表と列の名前について


Oracle APEXでアプリケーションを作成する際に、ワークスペースに複数のアプリケーションが作られることが一般的です。ですので、単に表の名前をEMPLOYEESやPERSONSとしたような場合に、表の名前が競合する可能性があります。

設定のprefix(オブジェクト接頭辞)にて、名前の先頭に識別子を一律に追加することができます。以下では文字列TSTをオブジェクト接頭辞として付加しています。
# prefix: tst
# semantics: default
emploees
   name vc80
   sal num
   com num
生成されるDDLの表名はTST_EMPLOYEESとなります。
-- create tables
create table tst_emploees (
    id                             number generated by default on null as identity 
                                   constraint tst_emploees_id_pk primary key,
    name                           varchar2(80),
    sal                            number,
    com                            number
)
;
オブジェクトを含むスキーマで識別すべきで、表名などに接頭辞を含めなくてもよい、という考え方はあるかと思います。しかし、Oracle APEXでアプリケーションを作成する場合、解析対象スキーマの変更によるセキュティ面での影響が大きいことを考慮すると、解析対象スキーマの変更を前提とせず、ひとつのスキーマ内でもオブジェクトの名前が競合しないように、オブジェクトに接頭辞をつけるのは良い習慣です。

オブジェクト接頭辞を指定した状態で、プリファレンスの主キーに表名を接頭辞として付けます(prefixPKwithTname)をONにすると、オブジェクト接頭辞も含んだ主キー列名になります。
# prefixPKwithTname: true
# prefix: tst
# semantics: default
emploees
   employee_name vc80
   sal num
列名はより説明的な方がSQLの可読性が高くなるという理由で、以下の表TST_EMPLOYEESの列NAMEをEMPLOYEE_NAMEにすることはあっても、TST_EMPLOYEE_NAMEとはしないでしょう。しかし、主キー列はTST_EMPLOYEE_IDになってしまいます。
-- create tables
create table tst_emploees (
    tst_emploee_id                 number generated by default on null as identity 
                                   constraint tst_emploees_id_pk primary key,
    employee_name                  varchar2(80),
    sal                            number
)
;
次に説明する、行キー、行バージョン番号のことも考えると、プリファレンスの主キーに表名を接頭辞として付けますはOFFが良いと思います。主キー列の名前は常にIDになり、行キーを別に作る理由が無くなります。

行キーと行バージョン番号


追加列の指定に、行キーと行バージョン番号というものがあります。


行バージョン番号だけを設定し、生成されるDDLを確認します。
# prefix: tst
# semantics: default
# rowVersion: true
emploees
   employee_name vc80
   sal num

列ROW_VERSIONが追加され、その列に値を設定するトリガーが生成されます。

-- create tables
create table tst_emploees (
    id                             number generated by default on null as identity 
                                   constraint tst_emploees_id_pk primary key,
    row_version                    integer not null,
    employee_name                  varchar2(80),
    sal                            number
)
;


-- triggers
create or replace trigger tst_emploees_biu
    before insert or update 
    on tst_emploees
    for each row
begin
    if inserting then
        :new.row_version := 1;
    elsif updating then
        :new.row_version := nvl(:old.row_version,0) + 1;
    end if;
end tst_emploees_biu;
/

行バージョン番号は、その行の更新が発生する度に1づつインクリメントされます。この列の使いどころの説明として、REST APIでの利用を考えてみます。

最初に、表TST_EMPLOYEESよりIDを渡して、EMPLOYEE_NAME, SALを取得します。このときROW_VERSIONも同時に取得します。

1. クライアントAがID 300のデータを取得しました。

Client A: https://xxxxxx/xxx/employee/300 (GET)

取得した値は以下です。

{ "id": 300, "employee_name": "山田太郎", "sal": 300, "row_version": 4 }

2. クライアントBも同じデータを取得しました。

Client B: https://xxxxxx/xxx/employee/300 (GET)

{ "id": 300, "employee_name": "山田太郎", "sal": 300, "row_version": 4 }

3. クライアントBがSALを400へ更新しました。

Client B: https://xxxxxx/xxx/employee/300 (PUT)

{ "id": 300, "sal": 400, "row_version": 4 }

送信されたデータに含まれるrow_version(4)と、表に保存されている行のROW_VERSIONが4で一致するので、SALは更新されます。更新された行のROW_VERSIONは+1されて5になります。

4. クライアントAがSALを200へ変更しようとしました。

Client A: https://xxxxxx/xxx/employee/300 (PUT)

{ "id": 300, "sal": 200, "row_version": 4 }

表に保存されている行のROW_VERSIONはすでに5になっており、送信されたデータとは異なるため更新は失敗します。

以上のように行バージョン番号は、異なるクライアントによって、アップデートが不用意に上書きされないことを保証するために使用されます。

HTTPのPUTを受け付けて列SALを更新する前に、ROW_VERSIONの値を参照する必要があります。そのため、以下のような問い合わせを発行します。

select row_version from tst_employees where id = 300 for update;

受信したrow_versionと比較して、一致していたら、

update tst_employees set sal = 300 where id = 300;

といった手順を踏むことになります。ここで主キー列の名称が表毎に異なっていると、row_versionを取り出す手順が煩雑になります。一意列が同じ列名ROW_KEYとして全ての表に定義されていることにより、少々扱いが容易になります。これが行キーの使い道です。

私の嗜好としては、主キーに表名を接頭辞として付けますがOFFで、主キー列がつねにIDという名前になっていれば、列ROW_KEYを定義する理由はないので、定義しないです。

Oracle APEXでは行バージョン番号の代わりにチェックサムを使うことで、上記の制御を実装しています。以下のような形式でチェックサムを計算し、保存されている行のチェックサムと受信したチェックサムに違いが無ければ更新処理を行います。

SELECT APEX_ITEM.MD5_CHECKSUM(ID, EMPLOYEE_NAME, SAL) FROM TST_EMPLOYEES WHERE ID = 300 FOR UPDATE NOWAIT;

行バージョン番号も使用できますが、デフォルトではチェックサムを使用します。そのため、Oracle APEXで表を扱う範囲では、列キーと行バージョン列の双方とも必要としていません。

チェックサムでは扱いが難しい、例えば表に列が大量に定義されている、Oracle APEXの外でデータが変更されることがある、といった場合に利用を検討します。

表と列のコメント


--または [] で表や列にコメントを付けることができます。
employees -- 従業員の情報
   employee_name vc80  -- 従業員名
   sal num  -- 月給

または

employees [従業員の情報]
   employee_name vc80  [従業員名]
   sal num  [月給]
これは単にクイックSQLへの記述ではなく、COMMENT文になります。
-- comments
comment on table emploees is '従業員の情報';
comment on column emploees.employee_name is '従業員名';
comment on column emploees.sal is '月給';
結果として、DESCコマンドや、USER_TAB_COMMENTS、USER_COL_COMMENTSなどを検索することでコメントを参照することができます。オンライン・ヘルプには列ディレクティブにのみコメントの説明がありますが、表にたいしてもコメントは有効です。

テスト・データの生成


表ディレクティブとして /insert 行数 を指定することで、テスト・データを挿入するINSERT文が自動生成されます。設定の挿入の生成がONである必要があります。これに対応するインライン設定はありません。


データ言語として、英語、日本語、韓国語、ドイツ語、スペイン語のどれかを選ぶことができます。こちらはインライン設定があります。
# language: "JA"
場合によっては、それらしいデータも挿入されますが(表EMPLOYEESとして定義した表にある列NAMEや、表TASKSとして定義した表にある列NAMEなど)、基本はデータ型を見て、その型にあったデータを適当に生成します。


履歴表の作成


表ディレクティブ /history を指定することで、変更履歴を保持する表、および変更されたデータを書き込むトリガーを生成することができます。

以下のように /history を付けるだけで、履歴保持を行うDDLが生成されます。
# prefix: tst
employees /history
   name vc80
   sal num
DcDLは非常に長いので掲載は割愛します。生成させる指定は簡単ですので、クイックSQLで確認してみてください。


デフォルトのセマンティクス


セマンティクスのデフォルトがCHARになっています。ですので、明示的に指定しないとVARCHAR2の長さなどの単位が、文字になってしまいます。データベースの設定に従う方が望ましいため、セマンティクスの設定はインライン設定に必ず含めることをお勧めします。
# semantics: default
無指定の場合は列NAMEの型は varchar2(80 char)として定義されますが、上記のセマンティックスのインライン設定を含めると varchar2(80) となります。


以上でクイックSQLの簡単な紹介は終了です。Oracle APEXでのアプリケーション開発の一助になれば幸いです。

完